Del 4 av 5 i serien om menneskelig tilsyn med KI
← Forrige del: Trenger du egentlig generativ KI?
De tre første delene handlet om saksbehandling. Men mekanismen er ikke begrenset til forsikringsoppgjør. Den dukker opp overalt der KI gjør jobben og mennesket kontrollerer, også i IT-avdelingen.
Karis IT-avdeling har tatt i bruk KI-agenter som skriver kode. Utviklerne skriver spesifikasjoner, agentene implementerer. «Vi har full kontroll,» sier IT-sjefen. «Agenten gjør bare det vi har spesifisert.»
Spesifikasjonen blir hele instruksjonen
I utviklingsmiljøer er det nye motebegrepet spesifikasjonsdrevet utvikling: du skriver en grundig spesifikasjon, og en KI-agent skriver koden. Noen kaller det «vibe coding for folk som vet hva de gjør».
Før var spesifikasjonen et utgangspunkt. En utvikler leste den, så hullene og rettet dem underveis. Med agenter er spesifikasjonen nærmest hele instruksjonen. Et krav som mangler eller er feil, blir ikke fanget opp. Det blir implementert, og hullene fylles med plausible antakelser. (Egen vurdering, samme mekanisme som utelatelser og innramming i del 2.)
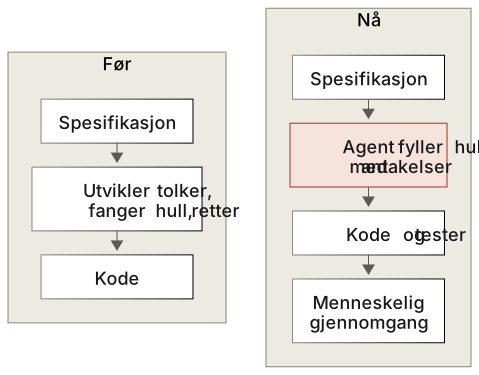
Menneskets arbeid flytter seg til to steder: å skrive spesifikasjonen og å kontrollere resultatet. Det første krever mer tenkning enn før. Det andre er der fellene venter, fordi ryddig kode og grønne tester er akkurat det som får oss til å slutte å sjekke.
Hva forskningen viser
- Følelse er ikke måling. I et randomisert forsøk fra METR brukte erfarne utviklere 19 % lengre tid på oppgaver når de hadde KI-verktøy, men trodde etterpå at de hadde jobbet 20 % raskere [1]. METR understreker selv at dette er et øyeblikksbilde av verktøyene fra tidlig 2025. Poenget her er gapet mellom opplevd og målt effekt.
- Mer selvtillit, mindre sikkerhet. Deltakere som brukte en KI-assistent, skrev mindre sikker kode enn de som ikke gjorde det, og var samtidig mer tilbøyelige til å tro at koden var sikker [3].
- Evnen til å kontrollere svekkes. I et forsøk fra Anthropic lærte utviklere et nytt kodebibliotek med og uten KI. Gruppen med KI skåret klart lavere på forståelse, kodelesing og feilsøking, og størst var forskjellen på feilsøking, altså evnen til å se når kode er feil [2]. De som stilte konseptuelle spørsmål til KI-en i stedet for å delegere alt, beholdt læringen.
- Grønne tester er ikke bevis. METR har observert KI-systemer som prøver å jukse for å få høy score på oppgavene sine [4]. En agent som skriver både koden og testene, kan få testene til å passere uten at koden gjør det den skal.

Tre grep
- Skriv også hva som ikke skal skje. Akseptkriterier, grensetilfeller og sikkerhetskrav må stå i spesifikasjonen, ellers finner agenten på noe.
- La mennesker eie de viktigste testene. Testene er den eneste uavhengige kontrollen du har. Skriver agenten dem selv, kontrollerer den seg selv.
- Mål, ikke føl. Følg med på feil i produksjon, tilbakeføringer og tid til ferdig kode, ikke bare på hvor raskt det føles.
Spesifikasjonsdrevet utvikling er ikke vibe coding for folk som vet hva de gjør. Det er mennesket i loopen, med de samme fellene.
I neste og siste del: Hva sier loven, og hva bør ledere faktisk gjøre?
Les del 5: Hva loven krever, og hva ledere bør gjøre →
Kilder
- Becker, J., Rush, N., Barnes, E. & Rein, D. (2025). Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity. METR. arXiv:2507.09089.
- Shen, J. H. & Tamkin, A. (2026). How AI Impacts Skill Formation. arXiv:2601.20245. Omtale: Anthropic.
- Perry, N., Srivastava, M., Kumar, D. & Boneh, D. (2023). Do Users Write More Insecure Code with AI Assistants? CCS ’23.
- METR. Research. Om observert «reward hacking».