Tenk deg at en KI-agent siterer et tall fra en kilde. Hvordan vet du at den ikke bare fant tallet opp, eller leste kilden feil? Et forskerteam ved Stanford har beskrevet et mønster de kaller Paper2Agent [1]: gjør en forskningsartikkel om til en agent som må gjenskape artikkelens egne resultater før den får lov til å svare på nye spørsmål artikkelen ikke stiller selv. Vi har prøvd samme oppskrift på noe helt annet enn en forskningsartikkel - NAVs kvartalsvise statistikknotater om arbeidsavklaringspenger (AAP) og uføretrygd.
Tanken er den samme som hos en revisor. Det holder ikke å lese at endringen er 1,4 prosent. Man regner den ut på nytt fra bilagene, og ser om man kommer til samme svar.
Fra PDF til datafil, men ikke til agent
Faktaportalen har lenge kjørt NAVs statistikknotater gjennom en AI-ekstraksjon: PDF-ene leses, hovedfunn og nøkkeltall trekkes ut, og resultatet skrives til to datafiler portalen bruker på sidene om AAP og uføretrygd. Det løste ett problem - tallene ble tilgjengelige for grafene - men skapte et nytt. En agent som spør Faktaportalens MCP-server om AAP-tall fikk bare tallene, ikke notatet de kom fra. Ingen hovedfunn, ingen av NAVs egne vurderinger, ingen diagnosefordeling, og ingenting som sa «dette er hva NAV selv skrev, med lenke til PDF-en».
MCP står for Model Context Protocol. Det er en åpen standard som lar en KI-assistent, for eksempel Claude, kalle verktøy på en server og få strukturerte svar tilbake, i stedet for å lete på nettsider og gjette.
Tre nye verktøy, og ett som etterprøver
Vi la til tre verktøy i den eksisterende MCP-serveren [4] - samme server, samme nøkkelkrav som før:
- Hent notatet selv. Ett verktøy gir hovedfunn, NAVs egen vurdering, diagnosefordeling og tallene for et gitt kvartal, alltid med lenke til NAVs PDF og hvilken periode notatet gjelder.
- Forklar begrepene. Et annet svarer på hva notatene faktisk mener med sine egne ord - hva er forskjellen mellom «smal» og «bred» i AAP-statistikken, og hva er de tre navnene NAV har brukt på uføretrygd over tid (uføreytelser til 2010, uførepensjon til 2015, uføretrygd i dag)? - hentet fra samme tekst som forklaringsboksene på portalen, ikke skrevet på nytt.
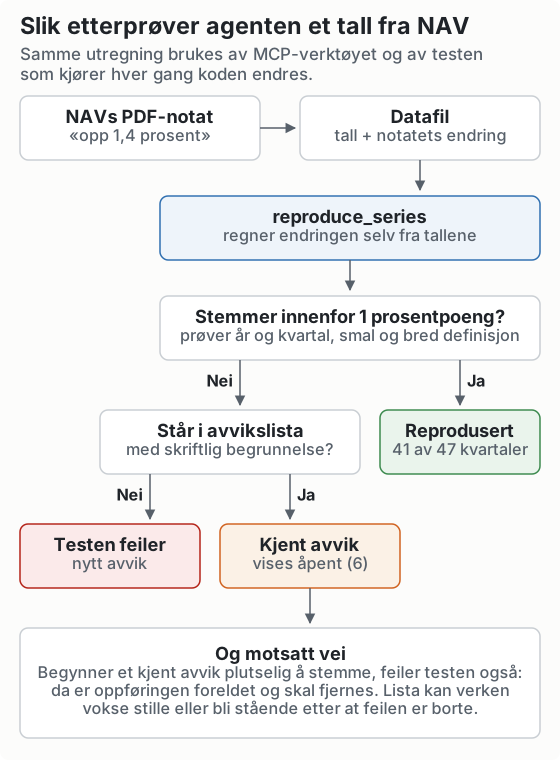
- Gjenskap tidsserien. Det tredje regner selv ut endringen fra ett kvartal til det neste, og setter sitt eget tall side ved side med endringen notatet oppgir.
Det siste verktøyet er kjernen i Paper2Agent-mønsteret: gjenskap kildens egne tall fra rådataene, i stedet for å bare gjengi dem.
Slik ser det ut i praksis
Si at du spør en KI-assistent koblet til Faktaportalens MCP-server: «Hvor mye endret AAP seg i første kvartal 2018, ifølge NAV?»
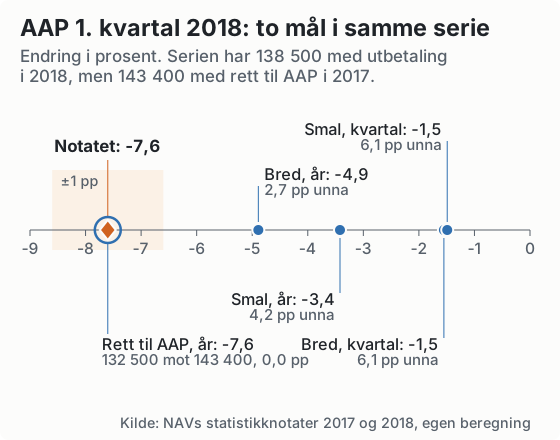
Datafila vår har et ferdig svar: minus 7,6 prosent. En assistent uten etterprøving ville sitert det. Men før den svarer, kaller den verktøyet reproduce_series med ytelse og kvartal:
{ "ytelse": "aap", "fra": "2018Q1", "til": "2018Q1" }
Svaret fra serveren ser slik ut (forkortet, men feltene og tallene er de ekte):
{
  "ytelse": "Arbeidsavklaringspenger (AAP)",
  "toleranse_prosentpoeng": 1,
  "kvartaler": [
    {
      "kvartal": "2018Q1",
      "hovedtall": 138500,
      "bitall": 190600,
      "egen_endring": -7.6,
      "beregnet_endring": -4.89,
      "metode": "yoy_bitall",
      "avvik_pp": 2.71,
      "innenfor_toleranse": false,
      "kjent_avvik": "Målbytte i smal-serien: 2018Q1 er antall med utbetaling (138 500), 2017Q1 antall med rett til AAP (143 400). Notatets -7,6 % stemmer med rett til AAP, 132 500 mot 143 400, men den tallraden står bare i oppsummeringen, ikke i serien. Ingen av de fire beregningsmåtene kommer nærmere enn 2,7 prosentpoeng."
    }
  ]
}
Feltene leses slik: egen_endring er endringen uttrekket vårt har registrert for notatet, beregnet_endring er det vi fikk da vi regnet selv, og metode sier hvilken regnemåte som kom nærmest (her år over år på den brede definisjonen). innenfor_toleranse: false betyr at tallene ikke stemmer, og kjent_avvik forklarer hvorfor vi ikke retter det bort.
Assistenten vet nå at tallet ikke kan tas for gitt, og hvorfor: tidsserien bruker ett mål for 2018 og et annet for 2017. Den kan hente selve notatene med get_statistikknotat og lese teksten. Ifølge oppsummeringen vi har hentet ut fra notatet, hadde 132 500 personer rett til AAP i mars 2018, mot 143 400 året før. Det gir nøyaktig -7,6 prosent. Da kan den svare noe slikt: «Ifølge NAVs notat gikk antallet med rett til AAP ned 7,6 prosent, fra 143 400 til 132 500. Merk at Faktaportalens tidsserie har antallet med utbetaling for 2018, 138 500, og ikke kan brukes til å regne ut denne endringen.» Det er et svar du kan etterprøve, i stedet for et tall du må stole på.
Ett tall som stemmer, og ett som ikke ser ut til å gjøre det
For AAP fjerde kvartal 2022 skriver NAV [2] at antall mottakere gikk opp 1,4 prosent fra kvartalet før. Regner vi selv fra tallene i tidsserien - 139 380 mottakere mot 137 423 kvartalet før - får vi 1,42 prosent. Det stemmer, innenfor avrunding.
For AAP første kvartal 2018 har datafila derimot minus 7,6 prosent som notatets endring [3]. Ingen av de fire måtene vi kan regne det på - år-over-år eller kvartal-over-kvartal, på den smale eller den brede definisjonen NAV bruker - kommer nærmere enn 2,7 til drøyt 6 prosentpoeng fra det tallet.
Forklaringen lå etter alt å dømme i vår egen tidsserie. Den smale serien skal telle det samme hvert kvartal, men gjør det ikke: fram til juni 2017 teller den personer med rett til AAP, og fra september 2017 personer med utbetaling av AAP. For mars 2017 står det 143 400 med rett til AAP, for mars 2018 138 500 med utbetaling. Det er to ulike mål. I oppsummeringen vi har hentet ut fra 2018-notatet, står det at 132 500 hadde rett til AAP. Regnet mot 143 400 gir det nøyaktig -7,6 prosent. NAVs tall ser altså ut til å stemme, mens serien vår sammenligner epler med pærer. Det er et poeng i seg selv: reproduksjonen fant ikke en feil hos kilden, den fant etter alt å dømme en feil i vår egen tidsserie.
Hele bildet: 41 av 47
Ett kvartal er et eksempel, ikke et bevis. Figuren under viser alle kvartalene der datafila har en endring fra notatet og vi har tall å regne fra: 24 for AAP og 23 for uføretrygd. Ligger et punkt på diagonalen, fikk vi samme svar som notatet.
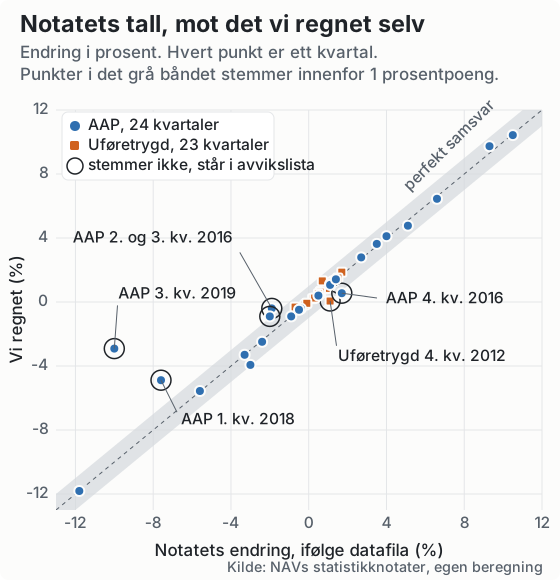
41 av 47 kvartaler stemmer innenfor ett prosentpoeng. De seks som ikke stemmer, har to forklaringer.
Grunnlaget mangler (fire kvartaler). NAV sammenligner med samme kvartal året før, og det kvartalet finnes ikke i datasettet vårt. Da kan vi bare regne kvartal over kvartal, som er et annet mål, og vi kan verken bekrefte eller avkrefte NAVs tall. Tallene fra notatene er slik vi har hentet dem ut med AI:
- AAP andre, tredje og fjerde kvartal 2016. Notatene sammenligner med 2015. Datafila har -1,9, -2,0 og 1,7, vi fikk -0,4, -0,9 og 0,6. For fjerde kvartal skriver NAV i teksten en nedgang på 1,7 prosent, så fortegnet i datafila er også feil.
- AAP tredje kvartal 2019. Notatet oppgir -10,0 prosent fra september 2018, men det kvartalet mangler i arkivet. Kvartal over kvartal gir -2,9.
Feil i hvilken serie verktøyet regner fra (to kvartaler). Her finnes grunnlaget, men ikke i den formen verktøyet bruker:
- AAP første kvartal 2018, beskrevet over: serien blander antall med rett til AAP og antall med utbetaling. Regnet på samme mål treffer vi notatets -7,6.
- Uføretrygd fjerde kvartal 2012. Notatet oppgir en økning på 1,1 prosent fra året før. Ifølge uttrekket fra notatet for desember 2011 var det 306 700 mottakere, og da blir endringen +1,1 prosent. Men verktøyet regner fra en serie som er laget for en graf over uføregrad, og den tar bare med kvartaler der uføregraden er oppgitt. 2011 er filtrert bort, så verktøyet må ty til kvartalet før og får 0,1.
To av de seks avvikene skyldes altså feil hos oss: en serie som blander to mål, og en serie som mangler kvartaler den burde hatt. De fire andre kan vi verken bekrefte eller avkrefte, selv om fortegnet for AAP fjerde kvartal 2016 også er feil hos oss. Ingen av dem peker mot en feil hos NAV.
I tillegg er det sju kvartaler i tidsserien der notatet oppga en endring, men der verktøyet ikke har noe å sammenligne med. Samme filter slår til her: for fem av dem finnes tallet året før i datafila, bare ikke i serien verktøyet regner fra, og regnet derfra stemmer alle fem. Bare to kvartaler, AAP første kvartal 2016 og uføretrygd tredje kvartal 2004, mangler grunnlag helt. De sju er ikke med i figuren, og de regnes ikke som avvik.
Hvorfor vi viser avviket i stedet for å skjule det
Den enkle løsningen ville vært å bare ikke nevne tallene som ikke stemmer. Den ærlige løsningen er å vise dem åpent, med en begrunnelse, og la testene passe på at begrunnelsen fortsatt er sann.
Avvikene står derfor i en egen, navngitt liste i koden, med tekst om hvorfor de ikke stemmer. En automatisk test kjører hver gang koden endres, og gjør to ting: den feiler hvis et nytt, udokumentert avvik dukker opp - en fersk regresjon som ellers ville gått ubemerket forbi - og den feiler også hvis et avvik som står i listen plutselig begynner å stemme igjen, fordi det da betyr at oppføringen er foreldet og skal fjernes. Verktøyet og testen bruker nøyaktig samme utregning, så de to kan ikke drifte fra hverandre over tid.
Andre som prøver noe lignende
Vi er ikke de eneste som prøver å gjøre KI-svar etterprøvbare. Tilnærmingene sjekker ulike ting, og forskjellen er verdt å kjenne:
| Hvem | Hva som etterprøves | Hvordan |
|---|---|---|
| Stanford, Paper2Agent [1] | At agenten kan gjenskape artikkelens egne resultater | Artikkelens kode pakkes som MCP-verktøy, og verktøyene testes automatisk før agenten tas i bruk |
| OpenAI, PaperBench [5] | Om en agent kan gjenskape forskning helt fra bunnen | Agenten skriver koden selv og vurderes mot tusenvis av delmål laget sammen med forfatterne |
| Google, DataGemma [6] | At statistikk i svaret kommer fra en offisiell kilde | Modellen slår opp tallene i Data Commons underveis i stedet for å skrive dem fra hukommelsen |
| Anthropic, Citations [7] | At et sitat faktisk står i dokumentet | Sitatteksten klippes ut av kildedokumentet, ikke generert av modellen |
| Meta, Chain-of-Verification [8] | At påstander i et utkast holder | Modellen stiller seg selv kontrollspørsmål, svarer på dem hver for seg, og retter utkastet |
Paper2Agent er publisert i Nature i september 2026. Der klarte systemet å gjøre 74 av 100 artikler i beregningsbiologi om til fungerende agenter, og 593 av 599 genererte verktøy besto den automatiske valideringen [1]. PaperBench viser hvor krevende det er når agenten må starte fra null: den beste agenten i OpenAIs første målinger klarte i snitt 21 prosent av delmålene [5].
Det vi har gjort, ligger nærmest Paper2Agent, men i det små. Et sitat kan stå ordrett i dokumentet og likevel være galt, og et riktig tall kan se galt ut fordi det sammenlignes med feil ting, slik -7,6 gjorde mot vår egen tidsserie. Å sjekke at sitatet finnes, er derfor ikke nok. Man må også sjekke at tallet lar seg regne ut.
Et prinsipp som er større enn NAV-notatene
Poenget generaliserer utover denne ene datakilden. Overalt hvor en språkmodell har trukket tall og påstander ut av et dokument - en årsrapport, en forskningsartikkel, et referat - står man med samme spørsmål: stemmer utdraget med originalen? Paper2Agent-mønsteret gir et konkret svar: bygg agenten slik at den må reprodusere kildens egne resultater fra grunnlagsdataene, og la den vise forskjellen når den ikke kan. En agent som aldri kan ta feil åpent, er ikke mer troverdig enn en som ikke er testet.
Grenser for eksperimentet
To ting dette ikke er. Det er ikke automatisk generering av en agent fra en vilkårlig PDF - det er Paper2Agents fulle ambisjon, men vi startet med data vi allerede hadde kuratert og kvalitetssikret manuelt. Og reproduksjonen dekker bare kvartalene der vi faktisk har begge tallseriene å regne fra; sju kvartaler faller utenfor serien verktøyet regner fra, og for to av dem finnes det ikke noe å regne fra i det hele tatt. Det er ikke et avvik å forklare bort - det er ærlig å si at vi ikke har nok til å prøve.
Kilder
- Miao, J., Davis, J. R., Zhang, Y., Pritchard, J. K. og Zou, J. (2026). Reimagining research papers as interactive and reliable AI agents. Nature.
- NAV: AAP-statistikknotat 4. kvartal 2022.
- NAV: Statistikknotat om nedsatt arbeidsevne og arbeidsavklaringspenger, mars 2018.
- Faktaportalen: AI-verktøy og MCP.
- Starace, G. mfl. (2025). PaperBench: Evaluating AI's Ability to Replicate AI Research. OpenAI.
- Google Research (2024). Grounding AI in reality with a little help from Data Commons.
- Anthropic (2025). Introducing Citations on the Anthropic API.
- Dhuliawala, S. mfl. (2024). Chain-of-Verification Reduces Hallucination in Large Language Models. Findings of ACL 2024.